

Tempo de execução do grupo de recursos
SubLane guia: conta pool tempo de execução.
Use isto para investigar as contas ocupadas, os descompassos ou o roteamento de conversas. Para uma primeira olhada em uma chamada falhada, comece com Uso diário.
SubLane rastreia locações de pedido de modelo e falhas de conta transientes em cada compartilhamento de pool de uma conta. O administrador pode inspecionar o estado de agendamento de Contas, alterar um limite por conta Configuração do agendamento, e inspecionar todas as chamadas concluídas sob Administração → Todos os pedidos. Cada usuário assinado, incluindo o administrador, tem um Geral → Pedidos vista.
Admissão e afinidade
Novas contas padrão para 30 solicitações de modelo simultâneas, configuráveis de 1 a 1.000. Atualizações preservam limites de conta salvos. Esta é a capacidade local do gateway, não uma garantia de provedor. A capacidade do espaço de trabalho é padrão para 128 operações, incluindo garçons e leituras de metadados compartilhadas, e pode ser configurada na inicialização. Os padrões de concorrência de membros são 10 e podem ser definidos de 0 a 1.000; 0 remove o limite de membro. As locações de conta permanecem mantidas até o fechamento do corpo através HTTP/SSE, compactação e WebSocket Reduzir um limite permite que os pedidos existentes terminem.
Uma conversa ociosa ou uma conversa aberta WebSocket A ligação não consome nenhum espaço de pedido de modelo entre turnos. Uma resposta completa liberta o seu espaço quando o corpo fecha. Após um cancelamento do cliente, uma Codex O fluxo pode continuar lendo por até três segundos para coletar o uso final antes de liberar seu slot; o prazo de solicitação total configurável (30 minutos por padrão) e o encerramento do processo ainda se aplicam. Se o cliente deixar um pedido em execução sem o envio de cancelamento, esse pedido mantém seu slot até que termine ou atinja o prazo de solicitação.
Uma conversação vinculada mantém sua conta. Uma mudança iniciada pelo cliente para um modelo diferente com histórico portátil completo pode selecionar uma conta de suporte quando a conta atual não puder servi-la; roteamento do modelo descreve as restrições de continuação. Capacidade e mudanças de saúde por si só nunca mover uma vinculação. Quando a capacidade está cheia, uma nova solicitação aguarda até 30 segundos por padrão, com no máximo 100 pedidos de espera por pool por padrão. Um slot de conta liberado ou um limite de concorrência aumentado desperta pedidos de espera. Uma fila completa retorna HTTP 429 account_queue_full; uma espera expirada retorna HTTP 429 account_wait_timeout, ambos com Retry-After: 1Esperar e essas rejeições locais não interrompem fluxos ativos ou penalizam a saúde da conta a montante.
Pedidos de espera contam para o membro concorrência e espaço de trabalho limites de admissão e consumir o membro RPM Eles não reservam licenças ou consomem uma vaga de conta até serem admitidos. O acesso ao grupo, a política do modelo, a habilitação do membro, a habilitação/ revogação/expiração da chave, a saúde da conta, a quota de assinatura e a franquia são novamente verificados antes do envio. O cancelamento do cliente e o desligamento do serviço removem prontamente os pedidos de espera. A espera libera o bloqueio de admissão e não mantém nenhuma transação de banco de dados; o uso completo é registrado antes de um slot liberado ficar disponível para outro pedido.
Resfriamento retorna HTTP 429 account_cooling com um cabeçalho Retry-After limitado e não está em fila de espera. Nenhum pedido muda automaticamente uma conversa existente para outra conta. Uma conversa sem sessão ou nova pode usar outra conta elegível imediatamente; uma conversa com ligação espera apenas pela sua conta original. Exaustão da quota de assinatura, limites de membros/espaço de trabalho e erros de admissão de licenças mantêm os seus guardas normais.
Sem Session_id ou um não vazio prompt_cache_key, cada chamada obtém uma seleção independente e um ID de correlação a montante aleatório. Ele não lê ou cria um registro de afinidade. Novas seleções nativas giram dentro de cada pool entre contas de assinatura elegíveis que suportam o modelo. Prefixos legados explícitos limitam a seleção para seu provedor. As conversas de grupo padrão existentes mantêm seu digest histórico.
O limite cobre solicitações de modelos; verificação de contas, descoberta de modelos e leituras de quotas permanecem limitadas pela política de admissão global existente e não consomem slots de pedidos de modelos. Essas operações de metadados não resolvem os resfriamentos de pedidos de modelos.
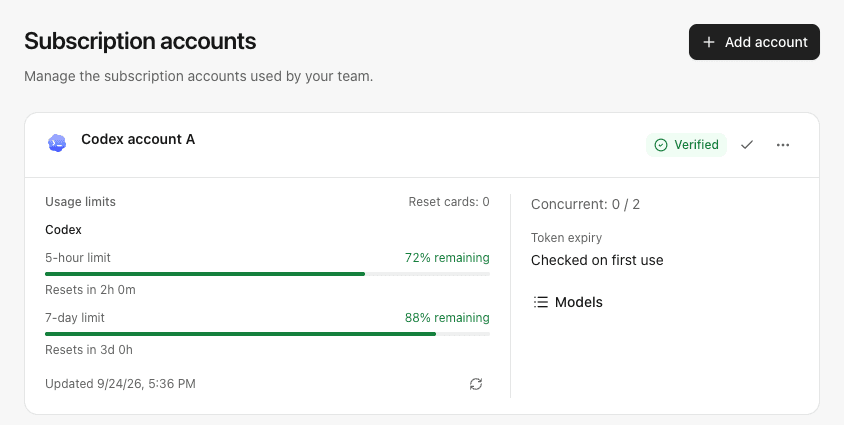
Agendamento de contas de exemplo e visualização de quota de assinatura com valores sintéticos:
Refrigeração e recuperação
O arrefecimento em toda a conta é reservado para as respostas a montante de 429. Retry-After é homenageado dentro de 1-3600 segundos; quando ausente ou inválido, o padrão de retrocesso configurável é de 5 segundos. Falhas de atualização credenciais têm seu próprio backoff. HTTP 408 e falhas de rede desconhecidas não esfriam toda a conta.
As respostas de 5xx a montante explícitas e os fluxos inválidos/ interrompidos são contados para a conta e o modelo seleccionados. O limiar por omissão são três falhas lógicas em dois minutos, seguidas de um arrefecimento do modelo de 10 segundos. As falhas repetidas aumentam o atraso até cinco minutos. O limiar, a janela e a duração inicial são configuráveis; um limiar de 0 desactiva as desactivações transitórias do modelo. Outros modelos permanecem elegíveis. As solicitações de recuperação ordinárias bem- sucedidas limpam o estado aplicável; os resultados tardios não podem limpar as falhas mais recentes. Antigravity Os limites de taxa do modelo mantêm as suas regras de recuperação abrangidas.
Antes de aceitar uma resposta a montante bem-sucedida, explicite HTTP 408, 500, 502, 503 e 504 rejeições podem ser repetidas duas vezes na mesma conta, com backoff limitado. Volta a verificar a subscrição actual, a chave, a política de grupo/modelo, a quota, o ciclo de vida da conta e as regras de conteúdo. Eles retêm uma locação, o ID da solicitação, o registo do histórico e a liquidação final. As dicas de repetição de longo montante são devolvidas em vez de serem reproduzidas precocemente. A incerteza da rede, 400/401/403/429, os fluxos aceites e a saída parcial não são automaticamente reproduzidos por este mecanismo. A tentativa de actualização de credencial 401 existente permanece separada.
HTTP SSE Emite batimentos cardíacos de comentários a cada 10 segundos enquanto o evento inicial é lido continua. Um tempo- limite de tempo- limite opcional de fluxo conta apenas os eventos iniciais; os batimentos cardíacos a jusante não podem esconder um modelo parado. Por omissão, desliga- se. O tempo- limite de cabeçalho de inferência é de cinco minutos, os metadados mantêm o seu tempo- limite mais curto e o tempo- limite total de requisição/redução é de 30 minutos. Veja a opção configuração de implantação.
Os administradores podem limpar os resfriamentos sem habilitar uma conta, renovando a autorização ou restaurando a quota de assinatura. As conversas existentes mantêm sua conta original. Os resfriamentos de conta/modelo sobrevivem ao reinício. A atualização limpa as penalidades transientes de toda a conta cujo escopo do modelo era desconhecido, preservando os limites de taxa reais.
Actualização e recuperação credenciais
Codex As credenciais são atualizadas a pedido no prazo de dois minutos após a expiração. Se a atualização falhar temporariamente, as solicitações poderão continuar com o token de acesso existente apenas enquanto ele tiver mais de 30 segundos restantes e não tiver sido rejeitado pelo upstream. A expiração é verificada novamente após a tentativa de atualização. Claude e Antigravity Manter os seus requisitos de validade existentes.
Falha nas tentativas de atualização compartilham um atraso de retentação específico da conta: 30 segundos, um minuto, dois minutos, quatro minutos, e no máximo cinco minutos. OAuth Retry-After é respeitado, até uma hora. Uma vez que o atraso expira, a próxima leitura de credencial ou pedido de modelo pode tentar novamente; não existe um ciclo de votação de fundo adicional. Outras contas mantêm seus próprios agendamentos de reteste.
Se nenhum token utilizável permanecer, as requisições do modelo retornam 503 account_refresh_failed com Retry-After. As falhas de atualização não acumulam as penalidades de resfriamento de chamadas de modelos. Uma atualização ou reautorização bem- sucedidas limpa o estado de reexperimentação de atualização. Os atrasos de repetição são locais de processo, enquanto uma rejeição upstream é armazenada com a credencial criptografada, de modo que o reinício não pode tornar esse token elegível para o retorno.
A Codex o endpoint do token deve retornar uma falha de credencial explícita, como invalid_grant ou refresh_token_reused, para exigir reautorização. HTTP 400/401, resposta proxy ou compartilhada OAuth O erro de configuração do cliente sozinho não marca uma conta como necessitando de reautorização. Um token atualizado que ainda é rejeitado pelo endpoint do modelo continua a exigir reautorização. As conversas existentes mantêm a sua conta ligada durante toda a recuperação.
Selecção consciente das quotas
Codex, Claude e Antigravity O tráfego do modelo inicia as actualizações de quota de fundo partilhada para contas de agrupamento elegíveis, sem esperar pelo IO do fornecedor. No máximo, duas leituras de quota são executadas simultaneamente dentro dos slots de admissão no espaço de trabalho; o duplicado lê coalesce, e aplicam- se as regras existentes de arrefecimento/recuperação. Não existe nenhum ciclo de votação em estado inactivo. Os recursos de partilha geridos são executados adicionalmente após a conclusão do pedido para conciliar o uso de espera, incluindo após o último pedido; veja reconciliação e pausas. Claude as janelas principais podem excluir uma conta esgotada. Antigravity verifica apenas o modelo nativo exato solicitado, com SDK pensando sufixos normalizados; outros modelos permanecem elegíveis e todo o estado de execução da conta permanece disponível.
Pela Codex e Claude, a seleção lê a normalização persistente main O limite de subscrição na mesma transacção curta que a política e afinidade do pool. Uma negação explícita, uma opção de limite atingido ou uma janela a 100% usada exclui a conta da nova selecção apenas enquanto a observação for fresca (dois minutos, encurtada por uma redefinição). Dados desconhecidos, estacionários, já actualizados ou já redefinidos não significam quota zero. Limites adicionais nomeados não são assumidos para mapear para modelos e não podem excluir uma conta inteira. A quota baixa mas positiva não altera os pesos da robina redonda. Uma actualização falha mantém a última observação bem sucedida; só pode afectar o escalonamento até ao seu prazo de frescura original, nunca indefinidamente.
Uma conversa encadernada cuja conta ou pedido Antigravity o modelo está esgotado retorna HTTP 403 quota_exhausted. O provedor é verificado novamente após o prazo de frescura instantâneo/redefinição; chegar a esse tempo não é uma promessa de que a franquia tenha recuperado. Ele nunca se move para outra conta. Rejeição de quota não aumenta falhas transitórias, e Limpar o arrefecimento não apaga a quota de subscrição. As contas mostram um estado de escalonamento de quotas distinto.
As observações bem- sucedidas são salvas antes da publicação e sobrevivem ao reinício. As linhas de quotas carregam a revisão existente do ciclo de vida da conta; desabilita/ habilita e reautoriza invalida as observações anteriores e as gravações condicionais rejeitam as atualizações mais antigas no voo. O esquema consolidado armazena metadados de revisão do ciclo de vida com as linhas de quota e os diagnósticos de solicitação.
Registos de pedidos recentes
Registros cobrem tentativas autenticadas de modelo que chegam ao agendamento do gateway, incluindo a capacidade de conta/rejeição de refrigeração. Falhas de autenticação, HTTP falha de validação do tipo corpo/conteúdo, rejeição global da admissão, descoberta do modelo, consultas de quotas, e WebSocket o pré-aquecimento não cria registos de chamadas de modelos.
Os metadados armazenados são limitados a IDs de usuário/chave/pool/conta, provedor, um identificador de modelo limitado, protocolo/operação, tempo de início, duração, ID de correlação de solicitação, latência de primeira saída nulo, resultado, código de erro higienizado, upstream HTTP status, e as contagens de entrada/saída/toque cacheado relatadas. Prompts, corpos de resposta, erros brutos de provedor, cabeçalhos, endereços IP, identificadores de sessão e credenciais não são registrados. As contagens de token em falta permanecem nulas. As contagens descrevem respostas individuais observadas; elas não são faturamento ou o registro de alocações de uso. Resumos diários independentes e limites de solicitação de membros são descritos em Controlos de equipa. Um córrego pode ter HTTP 200 ainda terminar com um erro, então o resultado e o estado de upstream são distintos.
Os registros pessoais são filtrados pelo usuário de sessão autenticado no SQL antes da paginação; um ID ou escopo de usuário fornecido pelo cliente não pode expandir o acesso. API resposta. Os usuários podem filtrar seu próprio histórico pelo resultado, modelo exato, API chave, ID de solicitação e intervalo de tempo, incluindo chamadas através de chaves que foram posteriormente revogadas. Os administradores podem filtrar separadamente por membro e conta de assinatura. As opções de chamada derivam apenas do histórico retido dentro do mesmo escopo de propriedade. Ambas as visões são paginadas em lotes de 50. No máximo, 5.000 registros são retidos em uma janela de sete dias. A limpeza é executada atomicamente ao gravar, e ao ler o histórico; os dados inativos são recuperados na próxima operação. Os IDs de registro monotônicos não são reutilizados após a limpeza de retenção. Os nomes de contas apagados renderizam como excluídos, sem excluir metadados históricos.
As tabelas de pedidos pessoais e de administradores mostram uma taxa de 'cache' de entrada ao lado da contagem de 'cache': fichas de entrada em 'cache' divididas por tokens' totais, formatadas como uma percentagem com no máximo um ponto decimal. Isto mede a partilha de fichas de entrada servidas da 'cache' a montante, e não a partilha de pedidos que atingiram uma 'cache'. Uma contagem de 'cache' zero notificada com entrada positiva mostra 0%; contagens em falta, entrada zero ou contagem de 'cache' superior à entrada total mostra um 'em'. A taxa é derivada dos metadados de pedidos existentes e não adiciona nenhuma coluna armazenada ou pedido de 'upstream'.
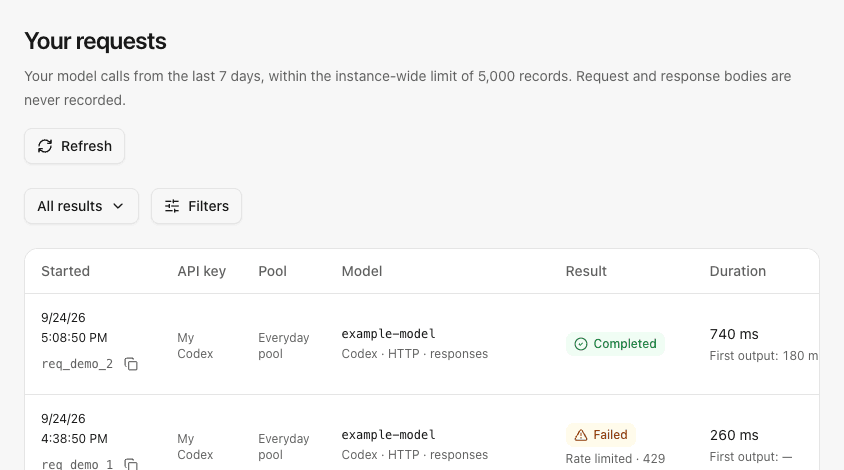
Cada nova tentativa de modelo recebe um servidor gerado req_… identificador, ignorando IDs fornecidos por chamadas. HTTP respostas devolvem-no em X-Request-ID; WebSocket turnos adicionar request_id para os eventos criados/completados/incompletos e erros de gateway. O ID de resposta upstream está inalterado. Os registros de antes da atualização não têm ID de correlação ou medição de primeira saída. A tabela de pedidos mostra um ID compacto abaixo de cada hora inicial com uma ação de cópia para o valor completo. Clicando no tempo de início abre seus detalhes com o ID completo.
first_token_ms O processamento de gateway mede o início do primeiro texto normalizado, raciocínio, resumo de raciocínio ou delta de argumento de ferramentas, incluindo agendamento e espera a montante. Não é hora do primeiro evento de ciclo de vida ou token renderizado pelo cliente. A compactação, fluxos sem delta observado e registros antigos mantêm nulo; a UI chama- lhe Primeira saída. A duração total ainda abrange o encerramento do corpo.
Exemplo de diagnósticos de solicitação pessoal com registros sintéticos:
API e armazenagem
GET /api/accounts/runtime: estado atual de agendamento e contagens modelo-pedido.PATCH /api/accounts/{id}/limits: setmax_concurrency(inteiro 1–1.000).POST /api/accounts/{id}/resume: clarear explicitamente o arrefecimento/fracassamento.GET /api/me/requests?cursor=0&outcome=: metadados de solicitação do usuário atual, para qualquer papel habilitado.GET /api/requests?cursor=0&account_id=&outcome=: administrador solicita metadados; o resultado pode ser sucesso, incompleto, erro, cancelado ou rejeitado.
Ambos os objetivos da história também aceitam model, request_id, key_id, from (inclusive Unix segundos) e until (exclusivo Unix segundos); o parâmetro de avaliação do administrador aceita user_id. A retenção permanece sete dias, independentemente da faixa solicitada. GET /api/me/requests/filters e somente administrador GET /api/requests/filters retornar opções de chamada/chave limitadas sem identidade de assinatura ou valores secretos.
Com excepção dos parâmetros de histórico explicitamente pessoais, estas rotas requerem uma sessão de administrador activada; as mutações mantêm a origem/JSON proteções. O esquema consolidado cria tabelas de tempo de execução e histórico com o escopo do espaço de trabalho. credentials.key em conjunto antes de substituir uma instalação de desenvolvimento.
Limites específicos do modelo
Estruturado explícito Antigravity As respostas de limite de taxa são reduzidas apenas quando o domínio de erro, razão e modelo corresponderem à solicitação selecionada. Desconhecido 429 respostas mantêm o arrefecimento em toda a conta. Os limites do modelo persistem durante o reinício e pertencem ao ciclo de vida da conta atual; a reautorização, a desativação/ativação e a limpeza manual invalidam o estado anterior.
Um modelo limitado retorna 429 model_cooling; o limite inicial do prestador é reportado como 429 model_rate_limited. Ambos preservam as dicas de repetição limitadas. Outros modelos permanecem utilizáveis e as conversas existentes mantêm a sua ligação à conta original. Após o arrefecimento, no máximo uma solicitação normal para esse modelo tenta recuperar de uma vez; nenhuma sonda de inferência extra é enviada. Sucessos antigos ou não relacionados não podem apagar um limite mais recente. Uma tentativa de persistência falha retém a restrição no processo atual e é registrada como uma falha de persistência.
Os cartões de conta exibem uma contagem de modelos limitados enquanto o agendamento geral da conta permanece disponível. Configurações de agendamento → Limpar o resfriamento limpa as contas e os modelos de arrefecimento, sem alterar a habilitação, a autorização ou a quota de subscrição. HTTP 403 é reportado como upstream_forbidden, em vez de um pedido de reautorização.
Revisões automáticas de aprovação do Codex
Solicitações codex-auto-review identificadas como guardian ou review podem usar metadados consistentes da conversa principal para dar preferência à conta dela, dentro do mesmo usuário autenticado e grupo de recursos. Uma vinculação existente da sessão filha tem prioridade. A conta ainda deve passar pelas verificações de suporte ao modelo, permissões, cota, alocação de uso e capacidade. Se os dados da conversa principal estiverem ausentes, conflitantes, ambíguos, expirados ou indisponíveis, a seleção normal é retomada sem alterar sua vinculação. Os identificadores de sessão e cache permanecem separados. Os testes HTTP e WebSocket usam dados sintéticos; a aceitação pelo cliente real do Codex ainda não foi verificada.
Distribuir novas conversas pela cota restante
SUBLANE_GATEWAY_QUOTA_WEIGHTED=true pondera pelo percentual restante da janela mais restrita. Apenas candidatos prioritários do mesmo provedor compatível com dados numéricos recentes e completos; Antigravity usa o modelo exato. Dados desconhecidos, antigos, parciais ou mistos mantêm rotação igual.
Desativado por padrão; exige reinício. Vínculos existentes, preferência da conta pai, permissões, alocações e concorrência continuam prioritários. Percentuais são heurísticos, não capacidades absolutas comparáveis entre planos.